8 EM 算法及其推广

EM 算法用于含有隐变量的概率模型参数的极大似然估计. 它大体上分为

1 EM 算法的引入

1.1 EM 算法

例子(三硬币模型)

设有硬币 A,B,C. 正面朝上的概率分别为 π,p,q. 进行如下实验: 先抛 A, 正面选 B, 反面选 C, 根据选择的结果抛硬币, 正面记为 1, 反面为 0; 独立的重复 n=10 次, 观测结果为 1,1,0,1,0,0,1,0,1,1. (我们无法看到抛硬币的过程, 只能看到结果) 现在要确定 π,p,q.
为此, 将模型写作 P(y|θ)=∑zP(y,z|θ)=∑zP(z|θ)P(y|z,θ)=πpy(1−p)1−y+(1−π)qy(1−q)1−y,z 即是隐变量, θ=(π,p,q) 是参数.
将观测数据表示为 Y=(Y1,⋯,Yn)T, 未观测数据表示为 Z=(Z1,⋯,Zn)T, 则观测数据的似然函数为 P(Y|θ)=∑ZP(Z|θ)P(Y|Z,θ)=∏j=1n[πpyj(1−p)1−yj(1−p)1−yj+(1−π)qyj(1−q)1−yj]. 则极大似然估计为 θ^=arg⁡maxθlog⁡P(Y|θ), 只能通过迭代的方法求解. 我们下面直接给出 EM 算法在这里的的表达式:


选取初值 θ(0)=(π(0),p(0),q(0)), 设第 i 次迭代得到 θ(i)=(π(0),p(i),q(i)). 则在第 i+1 次,

在上面的例子中, Y 表示观测变量, Z 表示隐变量. Y,Z 连在一起称为完全数据, Y 自己称为不完全数据. 这里 Y 的似然函数是 P(Y|θ), 对数似然是 log⁡P(Y|θ). EM 算法即要求 L(θ)=log⁡P(Y|θ) 的极大似然估计.

EM算法

输入 Y,Z,P(Y,Z|θ),P(Z|Y,θ)
输出 模型参数 θ

  1. 选取初值 θ(0).
  2. E 步: 在第 i+1 次迭代, 计算 Q(θ,θ(i))=EZ[log⁡P(Y,Z|θ)|Y,θ(i)](1.1)=∑zlog⁡P(Y,Z|θ)P(Z|Y,θ(i)).
  3. M 步:(1.2)θi+1=arg⁡maxθQ(θ,θ(i)).
  4. 重复 2, 3, 直到收敛.

上面的 Q(θ,θ(i)) 是算法核心, 称为**Q 函数**.

算法各步骤的说明

  1. 参数的初值可以任意选择, 但是 EM 算法对初值敏感.
  2. 尽管 Q(θ,θ(i)) 的两个参数分别表示要极大化的参数和当前的估计值, 但实际上是在求 Q 函数的极大值.
  3. 后面将证明每次迭代会使似然函数增大或达到局部极值.
  4. 体制迭代条件一般为对于较小的 ε1,ε2>0, ||θ(i+1)−θ(i)||<ϵ1∨||Q(θ(i+1),θ(i))−Q(θ(i),θ(i))||<ε2.

1.2 EM 算法的导出

我们希望极大化观测数据 Y 关于 θ 的对数似然函数 L(θ)=log⁡P(Y|θ)=log⁡∑ZP(Y,Z|θ)=log⁡(∑ZP(Y|Z,θ)P(Z|θ)). 假设经过某种迭代后 θ 的估计值是 θ(i), 希望新的估计值使得 L 增加, 也即 L(θ)>L(θ(i)). 根据 Jensen不等式, log⁡∑jλjyj≥∑jλjlog⁡yj, 则

L(θ)−L(θ(i))=log⁡(∑ZP(Y|Z,θ)P(Z|θ))−log⁡P(Y|θ(i))≥∑ZP(Z|Y,θ(i))log⁡P(Y|Z,θ)P(Z|θ)P(Z|Y,θ(i))−log⁡P(Y|θ(i))=∑ZP(Z|Y,θ(i))log⁡P(Y|Z,θ)P(Z|θ)P(Z|Y,θ(i))P(Y|θ(i)).

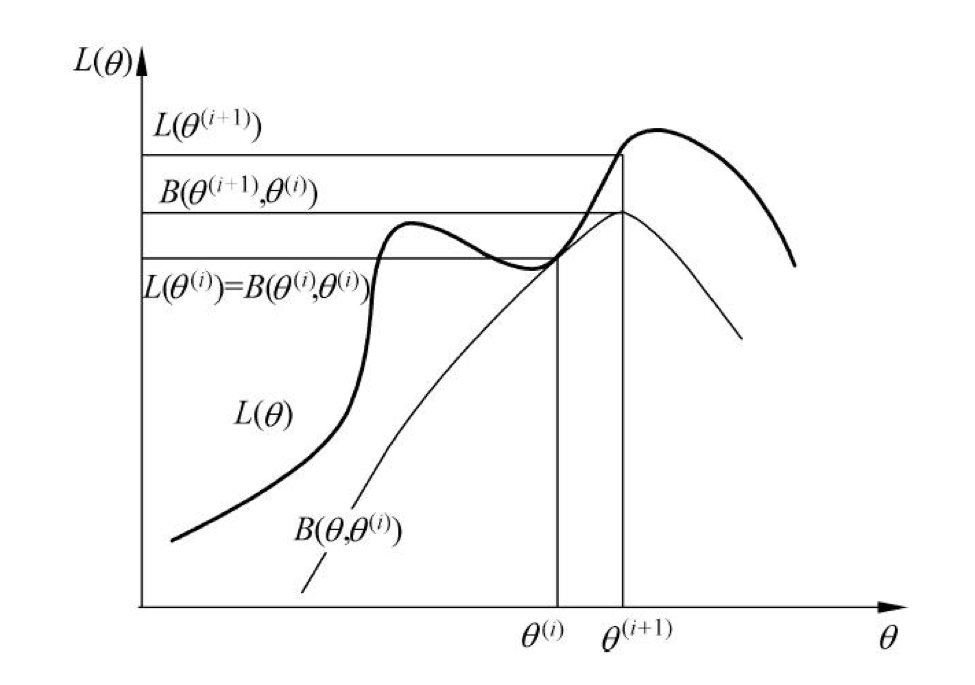
令 B(θ,θ(i))=L(θ(i))+∑ZP(Z|Y,θ(i))log⁡P(Y|Z,θ)P(Z|θ)P(Z|Y,θ(i))P(Y|θ(i))≤L(θ), 且容易知道 L(θ(i))=B(θ(i),θ(i)). 因此任意让 B(θ,θ(i)) 增大的 θ 也可以让 L(θ) 增大. 为了让增大尽可能大, 则θ(i+1)=arg⁡maxθB(θ,θ(i))=arg⁡maxθ(L(θ(i))+∑ZP(Z|Y,θ(i))log⁡P(Y|Z,θ)P(Z|θ)P(Z|Y,θ(i))P(Y|θ(i)))=arg⁡maxθ(∑ZP(Z|Y,θ(i))log⁡P(Y|Z,θ)P(Z|θ))=arg⁡maxθQ(θ,θ(i)).
这与 (1.1),(1,2) 等价.
Pasted image 20241127133756.png|300
从这张图看出, B(θ,θ(i)),L(θ)在θ(i)处相等, 随着θ(i+1)的取值, L也相应的增大, 此时B(θ,θ(i+1))的图像进行偏移, 进而迭代地找到L的极大值点. 从这里也可以看出, EM 算法无法找到全剧最值点.

1.3 EM 算法在无监督学习中的应用

无监督学习的训练集为 {(x1,⋅),⋯,(xN,⋅)}, 每个数据点没有对应的输出. 我们可以认为需要学习联合概率分布 P(X,Y), X 为观测数据, Y 为未观测数据.

2 EM 算法的收敛性

定理 2.1

设 P(Y|θ) 为观测数据的似然函数, EM 算法得到参数序列 {θ(i)}, 则 P(Y|θ(i)) 关于 i 单调递增.

定理 2.2

  1. 若 P(Y|θ) 有上界, 则 L(θ(i))=log⁡P(Y|θ(i)) 收敛到某一个 L∗.
  2. 在 Q(θ,θ′) 与 L(θ) 满足一定条件下, EM 算法得到的 θ(i) 的收敛值 θ∗ 是 L(θ) 的稳定点.

3 EM 算法在 Gauss 混合模型学习的应用

3.1 Gauss 混合模型

Gauss 混合模型

有以下形式的概率分布模型 (3.1)P(y|θ)=∑k=1Kαkϕ(y|θk) 称为** Gauss 混合模型**(Gaussian mixture model, #GMM )
这里 αk≥0 是系数, ∑k=1Kαk=1; θk=(μk,σk2), ϕ(y|θk)=12πσkexp⁡(−(y−μk)22σk2). (也即 Yk∼N(μk,σk2).)

注意, 这里的求和的意思是, 观测值依概率 αk 属于第 k 个子模型, 而非把每个模型的密度相加.

3.2 Gauss 混合模型参数估计的 EM 算法

假设观测数据 y1,⋯,yN 由 (3.1) 生成, θ=(α1,⋯,αK;θ1,⋯,θK).

  1. ^ 明确隐变量, 写出完全数据的对数似然函数

y1,⋯,yN 分别是依照概率 αk 来选择第 k 个 Gauss 分布模型 ϕ(y|θk), 并依此生成 yj. 因此, {yj} 已知, 但是 yj 来自哪个子模型 (k) 未知, 用隐变量 γjk 表示, 即 γjk={1,第j个观测来自第k个分模型,0,else. 是 0-1 随机变量. 这样, 完全数据(回顾定义)是 (yj,γj1,⋯,γjK). 于是写出似然函数P(y,γ|θ)=∏j=1NP(yj,γj1,⋯,γjK|θ)=∏k=1K∏j=1N[αkϕ(yj|θk)]γjk=∏k=1Kαknk∏j=1N[ϕ(yj|θk)]γjk=∏k=1Kαknk∏j=1N[12πσkexp⁡(−(yj−μk)22σk2)]γjk,
其中 nk=∑j=1Nγjk,∑k=1Knk=N. 因此对数似然函数为 log⁡P(y,γ|θ)=∑k=1K{nklog⁡αk+∑j=1Nγjk[log⁡(12π)−log⁡σk−(yj−μk)22σk2]}.

  1. ^ E 步: 确定 Q 函数
Q(θ,θ(i))=E[log⁡P(y,γ|θ)|y,θ(i)]=E{∑k=1K{nklog⁡αk+∑j=1Nγjk[log⁡(12π)−log⁡σk−(yj−μk)22σk2]}|y,θ(i)}=∑k=1K{∑j=1N(E(γjk|y,θ(i)))log⁡αk+∑j=1N(E(γjk|y,θ(i)))[log⁡(12π)−log⁡σk−(yj−μk)22σk2]}.

记 γ^jk=E(γjk|y,θ), 则 γ^jk=E(γjk|y,θ)=P(γjk=1|y,θ)=P(γjk=1,yj|θ)∑k=1KP(γjk=1,yj|θ)=P(yj|γjk=1,θ)P(γjk=1|θ)∑k=1KP(yj|γjk=1,θ)P(γjk=1|θ)=αkϕ(yj|θk)∑k=1Kαkϕ(yj|θk).
γ^jk 是当前模型参数下第 j 个观测数据来自第 k 个分模型的概率, 称为 k 对 yj 的响应度. 将计算结果代入, 得

(3.2)Q(θ,θ(i))=∑k=1K{nklog⁡αk+∑j=1Nγ^jk[log⁡(12π)−log⁡σk−(yj−μk)22σk2]}.
  1. ^ M 步: 迭代 θ

对于 (3.2), 分别对 μ^k,σ^k2 求偏导, 令其为 0 即可; 对于 α^k, 在 ∑k=1Kαk=1 下求偏导令为 0. 最后的结果如下所示:

Gauss 混合模型参数估计的 EM 算法

输入 y1,⋯,yN, GMM
输出 GMM 的参数

  1. 选取参数初始值.
  2. E: 计算分模型 k 对观测数据 yj 的响应度 γ^jk=αkϕ(yj|θk)∑k=1Kαkϕ(yj|θk),1≤j≤N,1≤k≤K.
  3. M: 更新模型参数μ^k=∑j=1Nγ^jkyj∑j=1Nγ^jk,σ^k2=∑j=1Nγ^jk(yj−μk)2∑j=1Nγ^jk,α^k=∑j=1Nγ^jkN,1≤k≤K.
  4. 重复 2, 3, 直到收敛.

4 EM 算法的推广

4.1 F 函数的极大-极大算法

F 函数

假设隐变量 Z 的概率分布为 P~(Z), 定义 P~ 与参数 θ 的函数 F(P~,θ): (4.1)F(P~,θ)=EP~[log⁡P(Y,Z|θ)]+H(P~), 称为 F 函数. 这里的 H(P~)=−EP~log⁡P~(Z) 是熵.

在定义中, 通常假设 P(Y,Z|θ) 是 θ 的连续函数, 因此 F(P~,θ) 是 P~,θ 的连续函数. F(P~,θ) 还有以下重要性质:

引理 4.1

对于固定的 θ, ∃!Pθ~ 可以极大化 F(P~,θ), 此时 P~θ 由下式给出 (4.2)P~θ(Z)=P(Z|Y,θ). 且 P~θ 关于 θ 连续.

引理 4.2

若 P~θ(Z)=P(Z|Y,θ), 则 (4.3)F(P~,θ)=log⁡P(Y|θ).

定理 4.1

L(θ)=log⁡P(Y|θ), θ(i), F(P~,θ) 定义如前. 如果 F(P~,θ) 在 P~∗,θ∗ 有局部/全局极大值, 则 L(θ) 在 θ∗ 也有局部/全局极大值.

定理 4.2 EM 算法的一次迭代可由 F 函数的极大-极大算法实现.

设 θ(i),P~(i) 为第 i 次迭代对应的估计, 在第 i+1 次迭代, 两步分别为

  1. 对固定的 θ(i), 求 P~(i+1) 使 F(P~,θ(i)) 极大化;
  2. 对固定的 P~(i+1), 求 θ(i+1) 使 F(P~(i+1),θ) 极大化.

4.2 GEM 算法

GEM 算法 1

输入 观测数据, F 函数
输出 模型参数

  1. 初始化 θ(0).
  2. 第 i+1 次迭代,
    1. 求 P~(i+1) 使 P~ 极大化 F(P~,θ(i)).
    2. 求 θ(i+1) 使 F(P~(i+1),θ) 极大化.
  3. 重复 2, 3 直到收敛.
GEM 算法 2

输入 观测数据, Q 函数
输出 模型参数

  1. 初始化 θ(0).
  2. 第 i+1 次迭代,
    1. 计算 Q(θ,θ(i))=∑ZP(Z|Y,θ(i))log⁡P(Y,Z|θ).
    2. 求 θ(i+1) 使 Q(θ(i+1),θ(i))>Q(θ(i),θ(i)).
  3. 重复 2, 3 直到收敛.
GEM 算法 3

输入 观测数据, Q 函数
输出 模型参数

  1. 初始化 θ(0)=(θ1(0),⋯,θd(0)).
  2. 第 i+1 次迭代,
    1. 计算 Q(θ,θ(i))=∑ZP(Z|Y,θ(i))log⁡P(Y,Z|θ).
    2. 进行 d 次条件极大化.
      首先, 在 θ2(i),⋯,θd(i) 不变的情况下求使 Q(θ,θ(i)) 极大的 θ1(i+1).
      然后在 θ1=θ1(i+1),θj=θj(i),j=3,⋯,d 的条件下求使 Q(θ,θ(i)) 达到极大的 θ2(i+1).
      如此继续, 经过 d 次条件极大化, 得到 θ(i+1)=(θ1(i+1),⋯,θd(i+1)), 使得 Q(θ(i+1),θ(i))>Q(θ(i),θ(i)).
  3. 重复 2, 3 直到收敛.